用于翻译 AtR 博客文章的 ATR AI 提示词套件
ATR AI 提示词套件
通往完整 AtR 翻译与 Blogger 发布提示词套件的简明入口,并附 Cosmic Transcriber 长音频转写工具。
当前提示词套件:Batch99。包含针对不同源文的翻译检查,以及 Hindi Seven Stages 工作流程支持,并保留早期保障。
提示词套件的简明用法
- 打开完整提示词套件页面,或下载与你的任务相符的提示词包。
- 使用当前具备思考/推理能力的系统,例如 ChatGPT、Claude、Google Gemini,或其他同类系统。
- 完整 Blogger 翻译先使用 Universal Intro Prompt,并同时提供源 HTML、目标语言和所需输出模式。
- 准备发布时,不要停在初稿;应按任务运行 Prompt 6、Prompt 9 与 Strict HTML QA。
可选配套工具
先使用上方的提示词与操作步骤。以下工具可辅助录音转写或文字朗读,并非使用提示词套件的前提。
Cosmic Transcriber
用你自己的 OpenAI API 账户,将受支持的音频或视频转成 TXT / Markdown 文字稿。
仅提供 GitHub 源代码。此为独立的浏览器版项目,并非上方桌面版 ZIP 的源代码。开发者已在 iPhone Safari 上测试;尚未在 Mac Safari 上进行手动测试。
CloudScribe Pro
用你自己的 Google Cloud Text-to-Speech 凭据,将校订后的文字生成 MP3 合成语音。
两款工具用途不同:Cosmic Transcriber 负责录音转写,CloudScribe Pro 负责文字朗读。各自需要自己的服务凭据;OpenAI 与 Google Cloud 用量分别计费,ChatGPT 订阅不包含这些 API 费用。
Cosmic Desktop 1.0.29(Windows x64):当前 ZIP 不包含 .NET 运行时。请先阅读包内 README.md;如未安装 Microsoft .NET 10 Desktop Runtime(x64),须另行安装。将整个 ZIP 解压到可写文件夹后,正常启动 CosmicTranscriber.exe;不要在 ZIP 内直接运行。API 用量另行计费。
MP3 无需转换器。其他受支持的本地音频或视频(例如 M4A、WAV、FLAC、Ogg/Opus、MP4 和 WebM)需要另行安装 FFmpeg 与 ffprobe,并使它们可从 PATH 找到;应用不会自带或下载这些工具。转换只取第一条音轨,生成临时有损 MP3,原文件保持不变。能否解码取决于转换器版本;受保护、损坏或没有可用音轨的文件可能被拒绝。导入与转换不会向 OpenAI 发送请求。格式与限制说明。
1.0.29 新增:首次转写操作指南
第一次使用 Cosmic Transcriber?在 First time here? 提示中选择 Start tutorial。七页指南会带你了解如何连接账户、加入录音、选择模型和输出文件夹、查看预计费用,以及找到完成的文字稿。
你可以跳过提示,随时关闭指南,或通过 Quick start 按钮或 F1 再次打开。指南可以保持在应用旁边;选择 Show this area 可转到相应的操作区域。
查看完整操作指南介绍(英文)。API 转写另行计费;阅读指南不会上传录音,也不会发起付费请求。
1.0.28 更新:修复鼠标无法打开模型列表及滚动时列表位置偏离的问题。转写期间按 Escape 会先询问是否停止,因为已发送的请求仍可能收费;本地导入仍可立即取消。完整更新与媒体说明。
CloudScribe Pro 1.0.8:把核对后的文字制作成 MP3
可选的文字转语音工具 · Windows · 1.0.8 版
先校订文字,再用自己的 Google Cloud Text-to-Speech 账户,把文章、译文或转录稿制作成 MP3。1.0.8 版加入可选教程,改善文件和文件夹导入,并在付费前检查更多可能的输出问题。跳过网址的功能也更谨慎。你仍可排列批量文件、核对费用,以及用完整文档比较支持的 Neural2 和 Chirp 3 HD 声音。使用本页提示词和翻译流程无需安装此工具。
1.0.8 具体改变了什么?
- 由你决定是否开始教程:新配置显示 First time here?,可选 Start tutorial 或 Skip for now。邀请不会阻挡工作区,也不会自动打开教程;选择会被记住,之后可通过 Help 重播。Back、Next、Escape 等引导操作不会批准费用或生成语音。
- 更谨慎地处理网址:选择跳过网址后,新规则仍能识别 84000.co 等链接,并减少把普通句子误删的情况。但它仍可能判断错误,请在保存前阅读完整预览。下方有具体规则和示例。
- 旧副本保持不变:已经保存的朗读副本和任务,继续使用创建时的规则。如需使用新规则,请从原文建立新的朗读副本,单独检查和批准。已有音频及结果仍待核查的任务记录会保留。
- 文件夹导入更可靠:CloudScribe 可识别支持的 Windows 云文件夹,包括可访问的 OneDrive 文件夹。它会跳过文件夹链接及不支持的特殊文件夹,避免反复扫描同一路径。无法读取或暂时不可用的文件夹会被提示,其余可读文件可继续处理。能从 OneDrive 导入,不代表也能把 MP3 保存到那里;请参阅下方的输出文件夹说明。
- 更妥善地处理长文件名:标题或 MP3 文件名超过 Windows 长度限制时,CloudScribe 会缩短名称,避免截断完整字符或表情符号。音轨编号和重名后缀也计入长度。某个文件无法加入文库,不再阻止所有后续文件;影响整批的故障仍可能停止导入。原文及已开始任务的名称保持不变。
- 生成文章前多做检查:CloudScribe 会先检查输出文件夹,并确认所需音频工具仍为获准版本,再建立新的批量文章任务;之后每次请求更多语音,包括恢复任务时,也会检查。Rehearse 可帮助发现问题,但不能预防所有后续磁盘故障。Long Audio 的保存方式不同:把 MP3 复制到所选文件夹时仍可能失败,而 Google 此时可能已收取语音费用。
早期改进继续保留:你可以关闭加载缓慢的声音列表、滚动阅读预览、比较整篇朗读、调整批量顺序、撤销操作,以及重新打开已保存草稿。付费请求仍须完成所需设置、核对和批准。如果之前的请求结果不明,请先核查,不要直接重试。
仍然保留的早期版本改进
保留的 1.0.7 与 1.0.6 改进
- 目录加载时可以关闭:Voices 正在加载或完整刷新声音目录时,可用 Close、Escape 或窗口关闭按钮退出。应用请求取消;迟到的结果不会覆盖较新的界面状态。若后台操作尚未清理完毕,重新打开后仍须等待,不能同时重复加载。
- 小窗口预览更易操作:朗读文字预览可以滚动,保存与关闭操作在较小窗口仍可到达。普通预览支持 Escape,并在关闭后把焦点返回可用的打开控件;已经开始的保存仍须完成后才能关闭。
- 大纲标签更明确:段落与当前文字有明确的辅助功能名称,不再把内部类型名称当作大纲项目标签。
同时包含 1.0.6 的两项更新:
- 两个声音列表按钮用途不同:Load connected voices / apply locale 加载可用声音,并保留同一账户、项目和声音列表中仍有效的检查结果,但不会延长有效期。Refresh connected voices (full verification) 会重新检查,之后可能需要重新核对原先的朗读计划。账户资料、项目或声音列表改变,或检查结果缺失、过期时,须重新验证。
- 历史网址省略规则:1.0.6–1.0.7 当时新准备的朗读副本使用 v2,可省略 84000.co 等符合限定规则的裸网址。已有 v1 副本、已绑定批次及任务保留原文字和规则;不会静默升级或借用旧批准。
整篇 Neural2/Chirp 3 HD 声音比较来自 1.0.5;批量拖放、排序、Undo、草稿保存和初版网址省略来自 1.0.4。付费生成、短样本、重播及导出的忙碌关闭保护仍然保留。关闭窗口不代表取消收费。
安装:完整解压 ZIP,保留整个文件夹结构;便携版通过 START-CLOUDSCRIBE.cmd 启动,其他安装方式请参阅指南。配置自己的 Google 凭据后,选择已验证的声音,核对文字和费用,再明确批准生成。不要共享凭据或复制他人的个人配置。
用同一篇文字比较两种声音
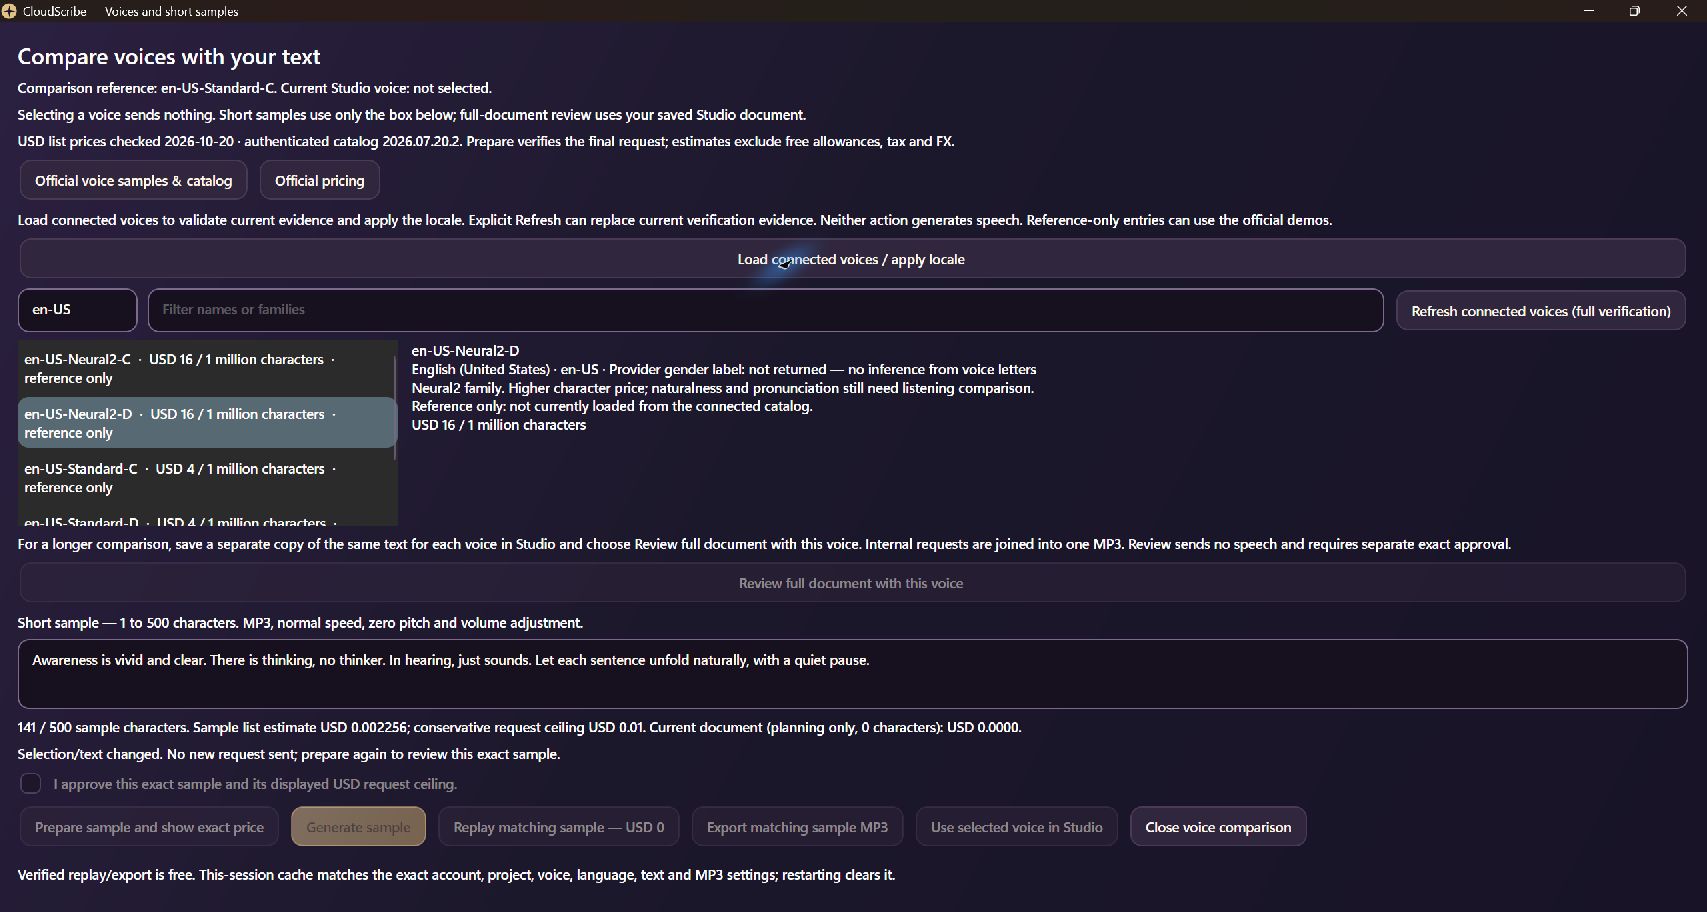
比较的是相同文字的不同合成朗读,不是复制某个人的声音。同一篇文字在不同声音下的时长可能不同。以下示例为英语声音;不要据此推断中文也有 Neural2,或任何目录声音都支持整篇朗读。
- 为每种声音保存独立文档:复制要比较的同一段完整文字,在 Library > New document 新建文档,分别命名并按 Ctrl+S。使用不同文档身份,不要覆盖原先已有音频的文档。保存所有编辑;空文档或未保存的修改不能进入整篇审核。
- 选择已连接的声音:打开 Voices,设置语言和地区,选择 Load connected voices / apply locale,再选取声音。这个按钮会保留同一设置中仍有效的检查结果,但不会延长有效期。需要重新检查时,使用 Refresh connected voices (full verification);之后可能要重新核对原先的朗读计划。两个按钮都只读取 Google 声音列表,不生成语音。标为仅供参考的声音不能用于生成。账户、项目或声音列表改变,或检查结果缺失、过期时,请重新验证并核对计划。
- 审核完整文档:选择 Review full document with this voice。它使用当前保存的 Studio 文档,不使用短样本框;核对文档、声音、已保存音频、剩余请求及最高费用。
- 先完成所需设置,再批准费用:CloudScribe 必须已配置为允许这一份保存的文字、所选声音及朗读计划。每份文档还须在应用内单独核对和批准费用。所需许可缺失、过期或不匹配时,不能生成。若出现 Choose a separate document for this voice,请打开为该声音保存的独立文档,不要修改旧任务来绕过提示。
- 保留并比较结果:另一种声音使用其独立文档重复上述流程。只有在所需配置、审核与批准齐备后才生成。保留各自 MP3,试听发音、停顿、名称及结尾;不要为了再次播放而重新生成。
声音列表加载缓慢时,可用 Close、Escape 或窗口关闭按钮退出。CloudScribe 会请求停止查询;后台操作结束前,可能需要稍候才能再次加载。较早的结果不会覆盖较新的选择。关闭窗口不代表取消收费,也不能撤销 Google 已收到的工作。生成、短样本、重播或导出进行中,应用可能要求先完成操作或安全停止,才能关闭。
选择声音与生成短样本是两回事。样本框为空、超过 500 字符,或所选声音类型不支持短样本,都不一定妨碍 Use selected voice in Studio;但声音仍须在当前连接的账户中可用。短样本和整篇文档各自需要设置、核对和批准。新增另一份独立比较的许可时,原有文档、音频、任务和费用记录会保留。
短样本、整篇文档和 Long Audio 有何区别?
- 官方浏览器样例:Google 预先录制的示例,不会朗读或发送你的文档。可用于初步试听,但不能证明你的长文效果。
- 应用内短样本:独立的 1 至 500 字符输入框,仅支持 Standard、WaveNet 和 Neural2。先审核准确费用,再明确批准 Generate sample;可能收费。Chirp 3 HD 不走这个短样本入口。
- 普通整篇路径:支持已获准入的 Neural2 与 Chirp 3 HD。Neural2 只使用纯文本 MP3 请求,实际序列化请求不超过 5,000 字节,包含 JSON 转义和字段;这不是 5,000 字符。优先使用自然边界,必要时只在完整 Unicode 文本元素之间分段;无法容纳的不可分割内容会停止,不会静默删字。此更新不新增 SSML 或声音控制支持。
- 仍有边界:整篇规划不受短样本的 500 字符限制,也不承诺无限长度。现有资源边界为每份源文档 1,000,000 个 Unicode 标量和 10,000 个覆盖分段,另须满足导入、请求大小、供应商、有效期和支出限制。Chirp 原有规划规则不变。每个批次使用一种声音;比较时须用各自独立的文档或批次及准确批准。
- Long Audio 需要单独设置允许使用的声音、语言、存储位置和费用上限。它在后台处理,不会立即返回整段录音。仅选中 Aoede 或 Neural2,不会自动启用这个功能,也不会扩大允许生成的范围。
应用内的估算、批准额度和预留额度都不是 Google 账单。请通过试听选择声音;价格更高,不代表一定更适合你的文字。阅读完整声音比较指南。
每份 TXT 对应一个 MP3
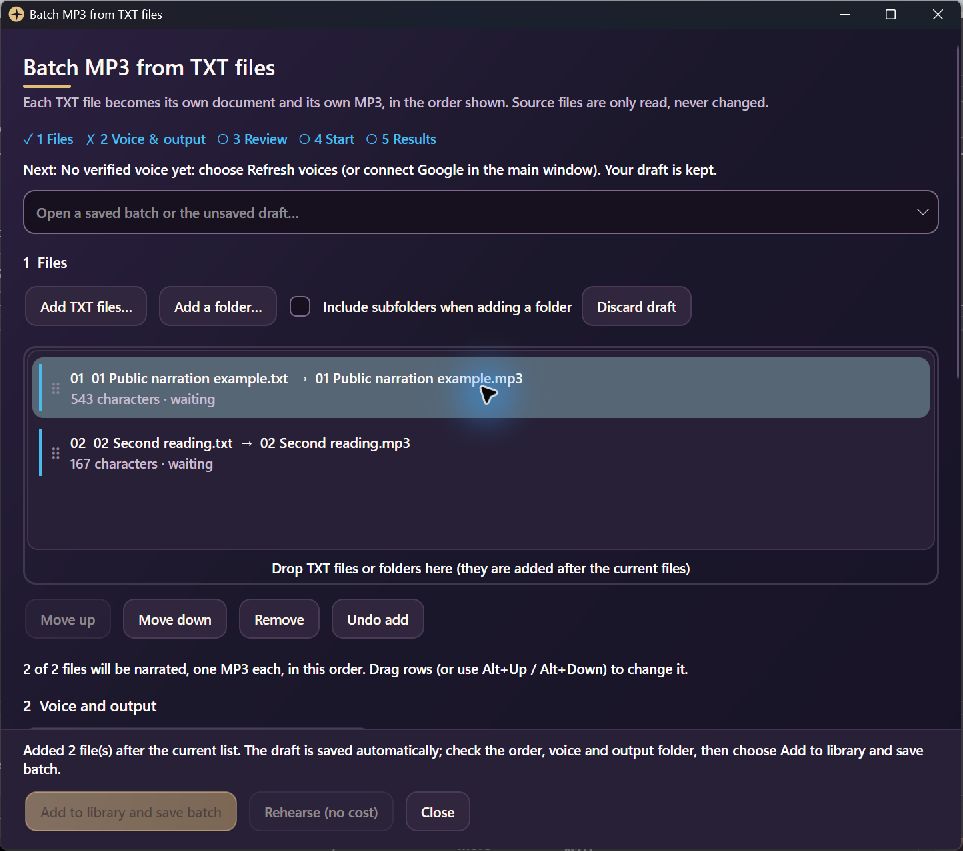
主窗口的 Create MP3 旁新增直接入口 Batch MP3。打开页面或播放器抽屉中的 Queue,即可看到 TXT 文件/文件夹拖放区。拖入只会准备草稿,不会生成语音;已有文件的批量列表也能继续接收拖放。可选择包含子文件夹,也可使用文件选择器。
新文件按文件夹及文件名的自然顺序追加,不打乱已排好的列表。同一个源文件重复添加会被忽略并提示;不同文件即使文字相同,仍保留为独立音轨,不会合并成一本书的单一录音。
先排列,再审核
拖动行的把手,按插入指示线调整顺序;Shift/Ctrl 多选后可整体移动,保持相对顺序。窗口内的 Undo 可撤销添加、移动、移除及丢弃草稿。键盘支持 Alt+上/下、Alt+Home/End、Delete 和 Ctrl+Z。
在批量窗口内直接选择或刷新声音。成功自动保存的草稿可在重新打开后恢复,等待声音配置时也不会丢失。若出现保存失败警告,请保持窗口打开,先解决问题。
跳过网址,不改原文
主动勾选 Skip web addresses in narration,预览实际朗读文字及省略数量,再保存独立朗读副本。原文档和原始 TXT 不变。新准备流程使用 v3:可省略明确的 HTTP/HTTPS、www 链接,以及 84000.co、EXAMPLE.COM 等保守识别的 ASCII 裸域名。行内 Markdown 标签及电子邮件保留。V3 还保留一些 v2 可能误删的句式;旧 v1/v2 副本继续保留其记录的文字和规则。请检查预览,不要假定每一次省略都正确。
批量草稿可选中某一行后使用 Preview selected narration text。仅含网址的输入在本地排除,不会作为空白付费请求发送;未发现可识别网址的文字无需额外副本。保存前请检查下方的规则限制和预览。
长文副本有独立审核入口
粘贴或已有文档可在 Create MP3 中预览,选择 Save and use narration copy。副本会打开并重新审核费用,且提供 Open original in Studio 返回原文。取消准备选项不会把网址恢复到已经保存的副本。
较长的副本提供 Review this copy as a one-file batch。选择输出文件夹后,按已配置的批量或 Long Audio 方式核对。新副本需要单独检查许可并批准费用。如果已有未保存草稿,CloudScribe 会保留它;请先完成或明确丢弃,再继续。
从文件到 MP3:建议流程
- 准备文件:核对文章或译文,将每个预期音轨保存成一份 TXT。拖入 Queue 或 Batch MP3,决定是否包含子文件夹,再排列顺序。
- 声音与输出:在批量窗口选择已验证声音、引擎偏好和输出文件夹;按需添加音轨编号、预览网址省略结果。空文件、无法读取、编码不支持或过大的文件会明确说明,不能直接朗读。
- 保存并审核:选择 Add to library and save batch。保存前会重新读取源文件;逐项检查引擎、最高费用、批量总额及缺少的配置或准入。
- 先演练,再批准:Rehearse (no cost) 检查文件、声音、输出文件夹可写性、音频工具、支出配置及批准状态,不生成语音。先解决所有阻碍;准备草稿或通过本地检查不等于批准付费。
- 运行与检查:完成所需批准后 Start 按顺序运行。结果分别显示完成、失败、待核查、跳过、等待,可打开输出文件夹或播放选中的 MP3。已有文件不会被覆盖,重名会添加编号后缀。
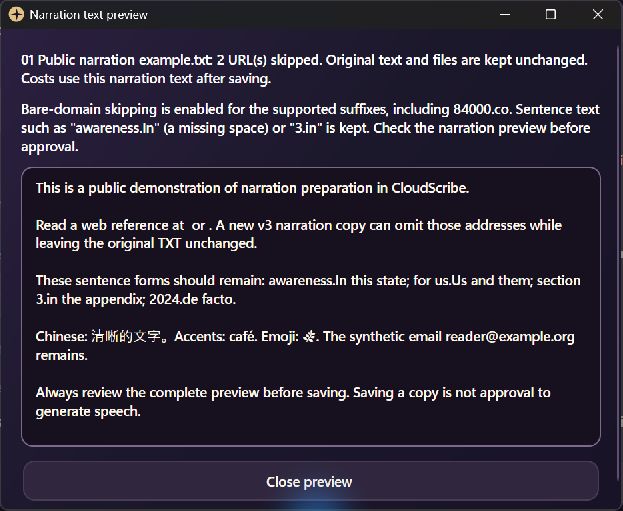
网址省略 v3:保存前检查完整预览
1.0.8 的新准备流程使用 url-omission-v3,可识别明确的 HTTP(S)/www 地址、行内 Markdown 链接目标,以及部分 ASCII 裸域名,例如 84000.co、EXAMPLE.COM、read.84000.co:443/translation?q=one%20two#part。Markdown 标签及周围标点、空白保留。准备文字不会生成语音。
为什么更新规则:1.0.6–1.0.7 的 v2 可能把普通句子误认成网址。V3 保留 awareness.In this state、for us.Us and them、section 3.in the appendix、2024.de facto。裸域名后缀须全部小写或全部大写,而非混合大小写;前一个标签通常须含字母,纯数字名称仅在 com、org、net、co、io 后缀下仍按域名处理。以 .in 或 .us 结尾、只有两段且没有路径或端口的名称会作为文字保留。
它仍不完美:像 nothing.ai is wrong 这样的全小写连写仍可能删掉 nothing.ai。直接与汉字相连的裸域名,例如 見84000.co譯本,则会保留。保留疑似内容意味着它会被读出。请检查结果,不合适时使用原文。
准确的识别范围与排除项
- 固定后缀名单为 com org net edu gov co io ai dev app info biz uk us ca au nz de fr jp cn in sg hk tw,并受上方 v3 条件限制。这是本地词法规则,不查询 DNS,不是公共后缀名单,也不证明网站存在。co.uk、org.uk、ac.uk、gov.uk、com.au、net.au、org.au、co.nz 等常见纯后缀保留。
- 裸主机名最多 253 个 ASCII 字符;每段标签为 1–63 字符,只含字母、数字及不位于两端的连字符。支持不超过 65535 的有效数字端口,以及受支持的 ASCII 路径、查询、片段和百分号转义。逗号、分号、感叹号会分隔裸地址,路径中也一样。
- 电子邮件、明确的非 HTTP 协议、本地路径、错误的标签/端口/转义、未配对的路径括号、Unicode 或 punycode 裸主机名、Unicode 裸路径及相邻 Unicode 字母/组合符号会保留。未知后缀、archive.zip、notes.md、this.is、小数及版本号等模糊内容也保留。明确 HTTP(S)/www 链接仍采用原有较宽的规则。
- 每份文档的网址准备仍受 16,777,216 个 UTF-16 文本单位及确定性工作量限制;复杂度检查失败不会返回半份副本。其他导入、提供商、批准及支出限制继续适用。
旧朗读副本继续使用创建时的规则。v1 会保留没有 http 或 www 的网址;v2 可能误删某些普通文字。预览会标明旧规则。重新打开副本、恢复导入或转入批量,不会更新文字,也不会把旧批准转给新请求。如果无法确认旧草稿应使用哪套规则,CloudScribe 会保留旧行为或停止操作,不会猜测。从未准备过副本的草稿,在首次开启跳过网址时使用 v3。
若要把新规则用于旧资料,请先保留已有任务记录和音频。从原文建立新的朗读副本,或从原始 TXT 建立新批次。阅读完整预览,完成新副本所需的设置,并单独批准费用。不要修改结果不明的任务后再次发送。旧的 Simplify URLs 编辑命令是另一个功能。
批准批量前,先选好输出文件夹
普通整篇朗读应选择电脑上已存在的本地文件夹,并使用新的 MP3 文件名。文件夹链接,以及 Windows 标为“重解析点”的其他路径(包括带此标记的云占位文件夹),即使看起来可写,也仍不受支持。你可以从支持的 OneDrive 文件夹导入 TXT,但不要因此假定 MP3 也能保存到那里。使用此方式时,请另选普通本地文件夹,不要默认沿用输入文件夹。
CloudScribe 会在建立新的批量文章任务前,以及之后每次请求更多语音时,检查目标文件夹,并核对所需的 FFmpeg/ffprobe 音频工具是否为获准版本,恢复任务时也一样。如果在建立新任务前停止,会提示尚未发送内容。对于已有任务,请修复文件夹或音频工具问题,再用 Check again 核查。它的音频、任务记录和预留费用额度会保留,不要为了重试而另建请求。修好文件夹不代表自动批准继续;已停止的任务可能需要单独核对和批准。已完成任务只检查现有输出,不会再次生成;最终导出还会再次检查文件夹和工具。
Long Audio 分两步保存结果:发送请求前检查音频工具,语音保存后再检查音频,最后复制到所选输出文件夹。复制时可以建立缺失的文件夹、重用相同文件,并拒绝覆盖不同文件。它与普通整篇朗读的文件夹检查并不完全相同,因此 Google 收费后仍可能发生复制失败。如果应用提示语音已保存,请重试本地复制,不要重新生成。任何方式都无法在付费前预知所有后续磁盘或同步故障。
长文章、批量费用与编辑限制
普通短请求的上限为编译后 5,000 字节,包含请求字段和转义,并非 5,000 个字符。较长的整篇文章及 Long Audio 路径需单独安装配置,并绑定准确的准入授权。批量可优先使用满足已安装范围的 Long Audio,否则须有普通文章引擎的准入;这不是不受限制的批量合成服务。
保存前会重新读取 TXT:文件改变时,会提示并采用当前内容;文件缺失时,不能保存。如果恢复已保存但中断的导入,会先检查源文件是否与当时完全相同。内容改变的文件不会替换已分配给请求的文字。已经导入的文档不会重复添加。
批量空闲时,可移动或移除尚未开始、没有保存任务的等待文件。Ready 或 Paused 批次可添加文件,但新增文件及请求内容变化须重新审核批准。已开始的任务受到保护;输出文件夹只能在任何文件开始前修改。已保存批次的省略网址选项会锁定,若需改变请准备新批次。
原文或副本变化会使未开始工作的批准失效;已开始或结果不确定的任务仍保留原身份用于核查。普通短请求、整篇文章及 Long Audio 的条件不同,请先阅读 批量朗读指南。
费用与隐私:应用分别显示预计最高费用、你批准的额度,以及为进行中或待核查请求暂留的额度。这些都不是 Google 账单。提交朗读的文字会发送给 Google Cloud。草稿只保存文件名、位置、大小及用于检查文件是否改变的校验信息,不保存原文;导入的文库文档和已保存朗读副本则会在电脑上保存文字。分享应用时,不要附带私人文字、账户凭据或个人配置。Google Cloud 的费用与 Cosmic Transcriber 使用的 OpenAI API 费用分开。
结果与恢复:完成表示 CloudScribe 已检查输出 MP3 与预期文件一致,不代表发音和听感一定正确。若只有本地复制失败,而且提示语音已保存,Retry 只会重试复制,不会重新生成。即使后来单独批准的新音频成功,较早结果不明的请求仍可能收费。完成后可生成播放列表及 CSV 摘要,不覆盖现有文件。
配合 Cosmic Transcriber:先把录音转成文字,检查并修订,再交给 CloudScribe 朗读。输出是合成语音,不是原录音,也不是原说话者的声音复制。
本节说明及四张 CloudScribe 演示截图针对 1.0.8 版。截图使用示例文字展示操作,并不表示已完成 Google 声音比较。这里的软件和界面检查,不能证明音质、屏幕阅读器的使用体验或所有显示缩放设置下的表现。分享 MP3 前,请试听并检查姓名、发音和内容是否完整。
Cosmic Transcriber v1.0.29
Cosmic Transcriber 是 Soh 已审查的 Windows 10/11 长录音转写应用,适合录制的讲座、访谈、播客、佛法开示、整批文件夹与多段录音。它支持可断点续传的批量转写、TXT/Markdown 输出,以及两种互补的 OpenAI 模型模式。
按用途选择模型
gpt-transcribe(默认):较新的高准确度通用模型。若最重视准确措辞、专有术语、多语言语音与否定词,请把它的结果作为控制稿。它支持语言提示、逐行关键词及录音背景说明,但在应用目前的文件工作流中不会加入说话者标签。gpt-4o-transcribe-diarize:较早但专门的说话者标注模型,可识别说话轮次并附时间戳;此模式下 Cosmic Transcriber 不会传送 prompt/背景说明或结构化关键词。不同 Part 的 Speaker 字母可能重新分配。
gpt-transcribe 生成较可靠的控制文字,再用 gpt-4o-transcribe-diarize 取得说话者结构。把两份结果都上传到 ChatGPT;要求它保留第一份的准确文字,只用第二份补上说话者标签、时间戳与轮次边界,并在不确定时明确标注而不是猜测。我提供同一段录音的两份文字稿。请以 gpt-transcribe 的结果作为准确措辞、人名、专有术语、否定词、重复语句与句子内容的控制稿;gpt-4o-transcribe-diarize 的结果主要用于说话者标签、时间戳与轮次边界。不要虚构语句或说话者身份;对齐不确定时请明确标注,不要猜测。
取得 OpenAI API key
- 登录 OpenAI API key 页面并建立新的 secret key。
- 在 OpenAI Platform 账单页面设置 API 付费。API 使用费与 ChatGPT 订阅分开计算。
- 密钥通常只会完整显示一次,请妥善保存;不要公开、放进公开文件或与他人共用。
快速使用
- 下载并解压 ZIP,然后以普通权限启动 Cosmic Transcriber,不要以管理员身份运行。
- 可为本次会话输入 API key、从
OPENAI_API_KEY读取,或选择用 Windows DPAPI 为当前 Windows 用户保存。 - 加入受支持的音频、视频文件或文件夹,选择模型与输出选项,然后开始转写;设置兼容时,已完成分块可从 checkpoint 续传。
目前仅限 Windows、需要联网,并支持在本地准备已录制的音频或视频文件;不是实时麦克风录音器或音频编辑器。只有 diarization 模式会输出说话者标签。模型与价格可能变化,请查看 OpenAI 当前 API 价格。


Comments